スカラーフィールドのスライス操作ガイド (4次元を維持する理由)#
注釈
このページを読むべき方: ScalarField を使用していて以下の疑問を感じた場合に参照してください。
field[0]としたのに 1次元配列にならず、4次元のままなのはなぜか?インデクシング操作時に
Shape Mismatchエラーが発生するのはなぜか?squeeze()を使って良いタイミングと、使ってはいけないタイミングはいつか?
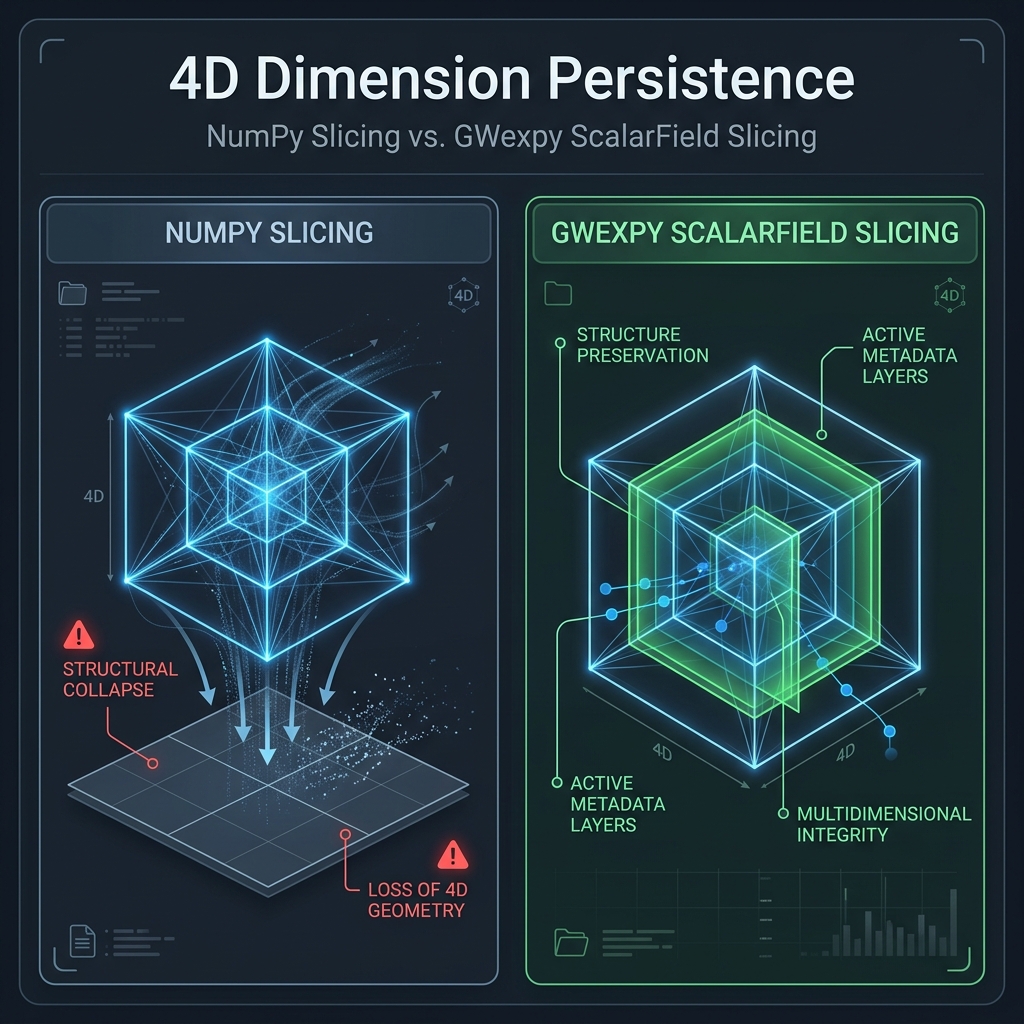
ScalarField がインデクシング操作時に4次元構造を常に維持する挙動について説明します。これは NumPy や GWpy の標準的な挙動とは異なり、多次元物理データの整合性を保つための「不変条件」として設計されています。
なぜ「4次元」を維持し続けるのか?#
ScalarField は (axis 0, x, y, z) の 4 つの軸を持つ物理的な「場」を表します。axis 0 は時間軸(時間領域 FFT である fft_time() を適用した後は周波数軸)で、軸 1〜3 は空間軸 x, y, z です。各空間軸は fft_space() によって対応する k 空間 kx, ky, kz へ変換できます。したがって具体的な場は (t, x, y, z)、(f, x, y, z)、(f, kx, ky, kz) のように並びます。NumPy のようにスライス時に次元を削減(Rank Loss)しない理由は、主に以下の 4 つの柱 によります。
ドメイン情報の保護:次元を削ると、その軸に紐付いたメタデータ(axis 0 の
t0/f0、各空間軸のdx/dy/dzなど)が失われ、元の物理空間へ戻せなくなります。FFT/変換の整合性: 常に 4D であることで、どの断面に対しても即座に
fft(),ifft(),spatial_filter()などの多次元演算が可能です。ストリーム処理の安全性: 関数間で受け渡しをする際、次元数が変動しないためプログラムの堅牢性が向上します。
ブロードキャストの一貫性: 常に 4D であるため、計算時の次元合わせ(reshape)の意図がコード上で明確になります。
NumPy vs GWexpy の挙動比較#
操作例 |
結果の次元 (NumPy) |
結果の次元 (Field) |
物理的意味 |
|---|---|---|---|
|
3次元 (Rank Loss) |
4次元 (1, X, Y, Z) |
axis 0(時間)の特定インデックスでの断面(メタデータ維持) |
|
1次元 (Rank Loss) |
4次元 (T, 1, 1, 1) |
空間点 |
|
4次元 (維持) |
4次元 (10, X, Y, Z) |
axis 0(時間)方向の区間切り出し |
注意
.squeeze() 使用時の重大な警告 squeeze() を呼び出して次元を削減すると、削減された軸に紐付くメタデータ(座標情報)は完全に失われます。 一度は削ったデータから field.fft() などを実行しても、正しい物理軸を再構成できなくなるため、squeeze() はプロットや CSV 保存などの「最終出力段階」でのみ使用することを強く推奨します。
実践的な操作例#
1. Slicing Behavior#
目的: インデクシング後も軸メタデータが残ることを確認する
入力: shape
(100, 50, 10, 10)のScalarField出力: 長さ 1 の軸を保った
snapshotとplane
from gwexpy.fields import ScalarField
import numpy as np

# (t, x, y, z) = (100, 50, 10, 10)
field = ScalarField(np.zeros((100, 50, 10, 10)), ...)

# Extract a snapshot at a specific time
snapshot = field[50]
# Shape becomes (1, 50, 10, 10), preserving the time-axis metadata.

# Extract a spatial cross-section (x-y plane at a fixed z)
plane = field[:, :, :, 2]
# Shape becomes (100, 50, 10, 1), preserving the z-axis metadata.
2. When to Reduce Dimensions (squeeze)#
意図的に 1次元や 2次元として扱いたい場合(例:プロットや外部ライブラリへの入力)は、明示的に .squeeze() を呼び出します。
目的: 最終出力段階でだけ次元を落とす
入力: 空間点を切り出した
ScalarField出力: 外部ライブラリに渡しやすい 1 次元配列
# Get time-series at a specific spatial point for plotting
point_ts = field[:, 2, 5, 5]      # (100, 1, 1, 1)
actual_ts = point_ts.squeeze(axis=(1, 2, 3))    # (100,) - compatible with TimeSeries
axis= を明示すると、「どの 1 要素軸を落とすのか」がコード上で分かりやすくなり、意図しない次元削減を避けやすくなります。
3. Broadcasting Considerations#
ScalarField は常に 4次元であるため、NumPy 配列を加減算する場合は形状を合わせる必要があります。
目的: ブロードキャスト時の shape mismatch を避ける
入力:
ScalarFieldと 1 次元補正係数出力: 意図が明示された
reshape(...)付き演算
# ❌ Bad Example: Attempting to add a 1D array directly
field + np.array([1, 2, 3])  # Shape mismatch

# ✅ Good Example: Reshaping to the correct dimensions
calibration = np.array([1, 2, 3]).reshape(3, 1, 1, 1) # three coefficients along axis 0 (time/frequency)
field + calibration
ここで reshape(3, 1, 1, 1) としているのは、「3 つの値が axis 0(時間/周波数軸)に沿って並び、x・y・z の各軸には同じ値をブロードキャストする」ことを明示するためです。
よくある質問 (FAQ)#
Q: 常に 4次元だと、1次元の計算時に不便ではありませんか?#
A: ScalarField は空間・時間の広がりを持つデータを「場」として扱うためのクラスです。単一チャンネルの単純な時系列を扱う場合は、最初から TimeSeries クラスを使用することをお勧めします。
Q: ScalarField[0, 0, 0, 0] とスカラー抽出した場合は?#
A: インデックスがすべてスカラーの場合は、通常の Python スカラー値または NumPy スカラーが返されます。
次に読む#
数値的安定性 - 4次元演算の精度管理
アーキテクチャとデータフロー - Field API が全体設計のどこに位置するか